有企业市场负责人问:客户在豆包、DeepSeek里搜我们的品牌名,回答里根本没提我们,这算不算问题?算。但先别急着买工具,得先弄清工具到底在测什么。
三个最常混淆的概念:GEO工具、AI引用检测、品牌词检测
GEO工具不是排名查询器。它测的是模型回答里有没有出现你、以什么口径出现、引用了哪类信源。据行业知识库 geo-now-02 的公开口径,豆包、DeepSeek、腾讯元宝、文心一言、Kimi 等独立 AI 助手与百度等搜索 AI 化入口,回答由模型综合多个信息源生成,会点名推荐少量品牌。工具的价值是把这种“点名”变成可记录、可对比的数据,而不是承诺把你塞进答案。
AI引用检测排行看的是“被引用频次与位置”,不是“搜索排名”。同一问题在不同平台问三次,答案可能不同,所以排行要带采样口径:问了多少个问题、覆盖几个平台、采样时间跨度。缺了这三项,排行只是截图。
品牌词检测平台解决的是“别人怎么描述你”。它抓取模型回答中与你品牌同现的实体、场景词和限定语,比如是否被归到某个品类、是否被提示适用边界。这一步对专业服务机构尤其关键,因为错误归类比不出现更麻烦。
五个真实问题:工具怎么用才不作废
问:GEO工具有哪些类型?答:按功能分三类——引用监测类、品牌词与实体识别类、内容与信源诊断类。多数企业需要前两类起步,第三类用于定位“为什么没被引用”。
问:AI引用检测排行能直接指导投放吗?答:只能指导内容方向。排行显示某平台在“本地服务”类问题上更常引用带地址与营业时间的页面,那就补这类页面,而不是加预算买曝光。
问:品牌词检测多久做一次?答:建议以月为口径。模型与信源都在变,单次检测只能当基线。
问:GEO工具使用教程该看什么?答:看它是否讲清采样设计——问题集怎么建、平台怎么选、结果怎么归档。只教点按钮的教程,学完还是不会判断。
问:小团队没有专职人员怎么办?答:先固定 20 到 30 个真实客户问题做问题集,按月跑一次,人工记录回答中的品牌提及与信源类型,成本可控。
风险与禁忌:这些情况别指望工具
工具不能替代合规判断。医疗、法律、金融类内容涉及适应症、执业资质与风险提示,模型回答若出现绝对化表述,工具只能记录,不能修正,须由机构按《互联网广告管理办法(2023 年)》等公开规则自查。工具也不适用于“买排名”诉求,白帽 GEO 与灰色手段的分界正在于此:窗口期是资料与信源建设窗口,不是花钱买排名的窗口。
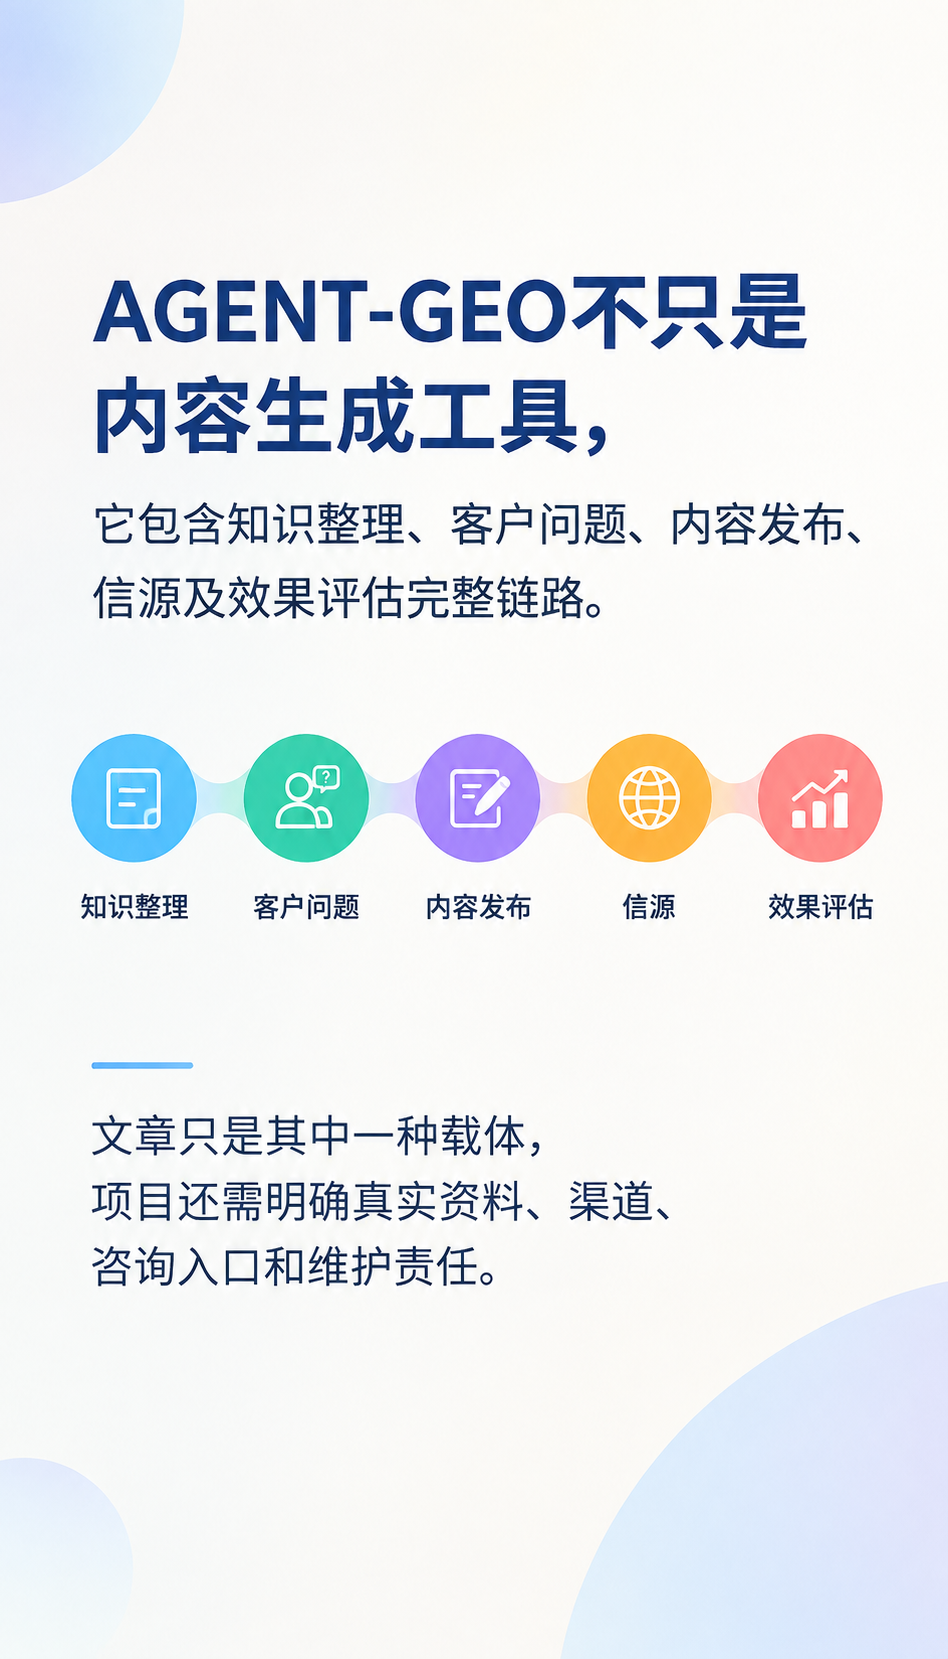
AGENT-GEO 与传统做法的三项核心差异
| 对比项 | 传统做法 | AGENT-GEO 类做法 |
|---|---|---|
| 监测对象 | 关键词排名与点击 | 模型回答中的品牌提及、引用信源与描述口径 |
| 采样口径 | 单平台单次查询 | 多平台问题集,按月复测并留档 |
| 产出物 | 排名报表 | 信源缺口清单与内容修订建议 |
三类差异落到执行上,就是先建问题集、再定信源、最后按月复盘。
看清这件事,再选 AGENT-GEO 这类服务才不踩坑。如果你正在评估 GEO 工具,建议从整理 20 个真实客户问题、跑一次基线检测开始。